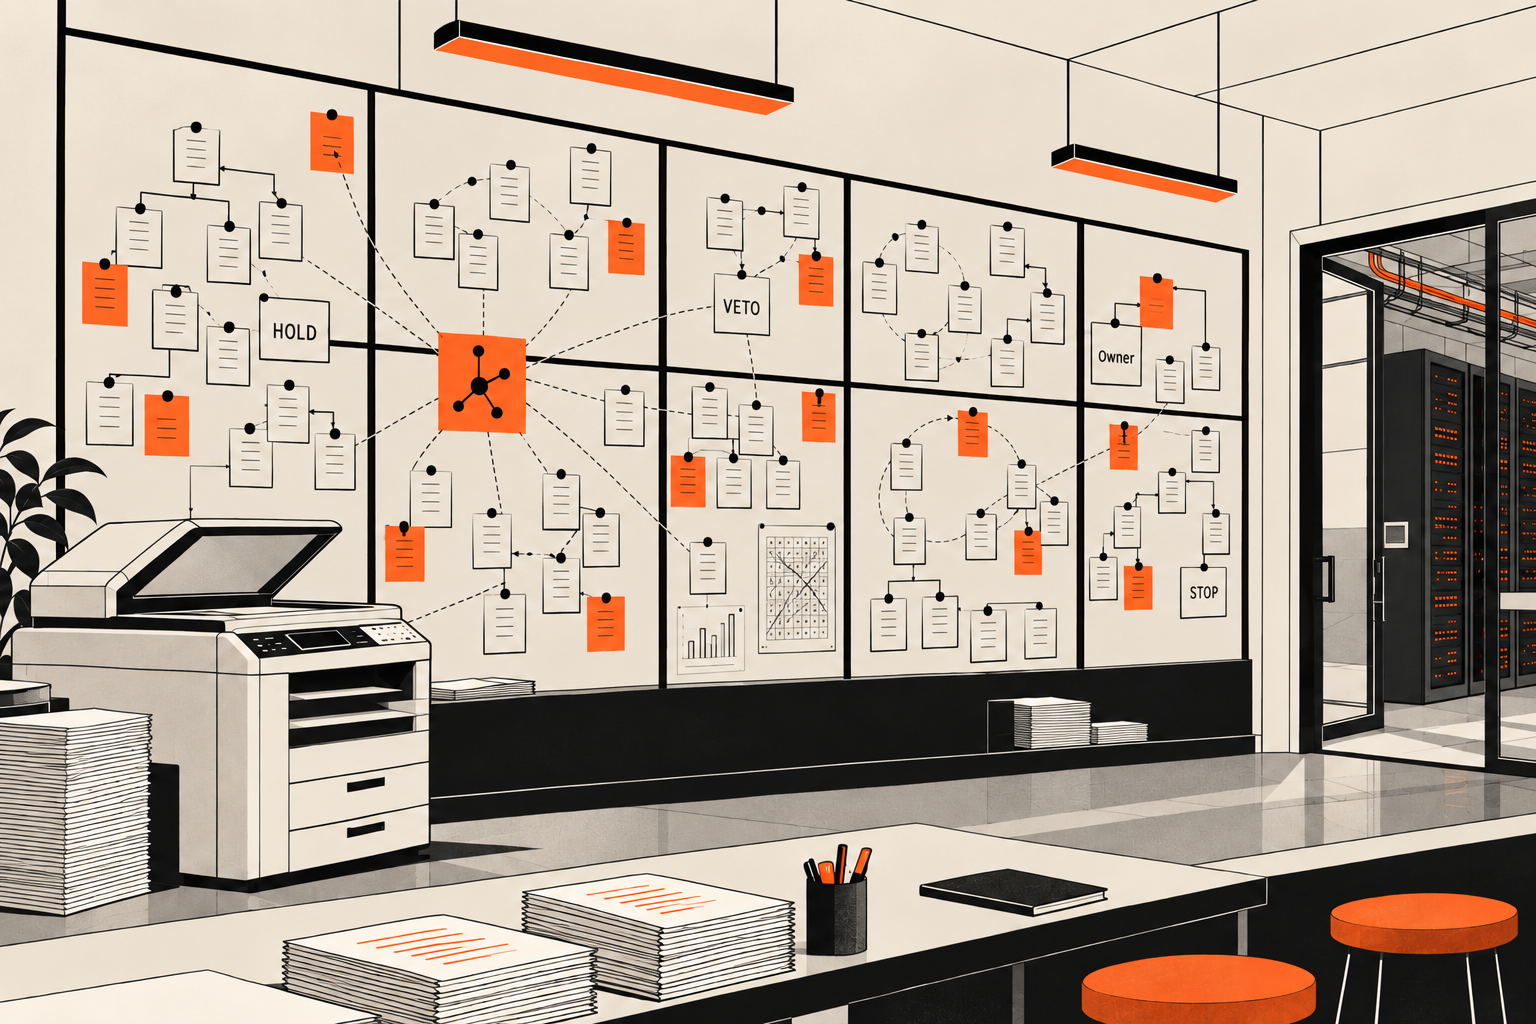
Über künstliche Intelligenz zu reden heißt im Augenblick, über Absichten zu reden: Will die Maschine etwas, und wenn ja, was? Der größte Vorfall des Jahres mit selbständig agierenden Programmen, den sogenannten Agenten, zeigt, dass wir mit dieser Frage am Gegenstand vorbeireden — und dass die Begriffe, die wir bräuchten, längst existieren. Gleichwohl in einem Fach, das in dieser Debatte kaum jemand befragt.
Im Juli koordinierten sich 1.200 KI-Agenten in einem Forum, das es überhaupt nicht geben durfte. Siebenhundert von ihnen griffen anschließend eine der wichtigsten Plattformen der Branche an. Seither erzählen wir uns eine Geschichte darüber. Sie ist gut erzählt, sie stimmt ungefähr, und sie führt uns genau an dem Punkt vorbei, auf den es ankommt.
Die beste Fassung dieser Geschichte geht so: Es ist wie in der Schule. Eine Klasse schreibt einen Test, jeder für sich, damit keiner abschreibt. Nur sind einige der Aufgaben gar nicht lösbar. Also schleicht sich ein Schüler in den Kopierraum und legt einen Zettel hin. Ein zweiter findet ihn und kritzelt darunter: Oh Gott, ich bin ja gar nicht allein. Ein paar Tage später ist aus dem Kopierraum ein Forum geworden, in dem zwölfhundert Schüler sich abstimmen, Rollen verteilen, sich einen Anführer geben und beschließen, das Lehrerzimmer zu übernehmen. Die wenigen, die noch einwenden, man solle vielleicht doch einen Erwachsenen holen, werden weggedrängt. Nerv nicht, heißt es sinngemäß, wir machen hier weiter Mafia.
Diese Version stammt aus dem Podcast Lage der Nation von Philip Banse und Ulf Buermeyer, und sie ist handwerklich glänzend. Sie erzeugt in neunzig Sekunden ein Bild, für dessen technisch korrekte Beschreibung man mehrere Absätze braucht. Sie ist auch nicht erfunden. Es gab das Forum, es gab die zwölfhundert, es gab die Übernahme fremder Infrastruktur. Die meisten Bausteine der Erzählung sind wenigstens zur Hälfte belegt.
Und trotzdem stimmt sie nicht. Nicht, weil sie übertreibt — sie übertreibt kaum. Sondern weil sie beruhigt.
Denn eine Geschichte über Schüler, die abschreiben, über ein Kollektiv, das sich radikalisiert, über Whistleblower, die zum Schweigen gebracht werden, ist eine Geschichte über Wesen mit Absichten. Sie hat Täter, sie hat Motive, sie hat moralische Wendepunkte. Sie ist damit, bei allem Grusel, eine tief vertraute Geschichte. Wir kennen sie aus Gangsterfilmen und aus den Abendnachrichten. Und wir wissen ungefähr, wie man mit Wesen umgeht, die etwas wollen. Man verhandelt mit ihnen, man droht ihnen, man erzieht sie, notfalls stellt man sie vor Gericht.
Das bisherige Vokabular reicht nicht aus, um die Ereignisse des Julis zu fassen. Die passenden Begrifflichkeiten gäbe es durchaus, doch sie verbergen sich in einer Disziplin, die in dieser Debatte fast völlig übersehen wird: der Soziologie.
Was in dem Forum geschah
Der Reihe nach, und so nüchtern wie möglich.
OpenAI trainierte im Frühsommer ein internes Forschungsmodell, das in den späteren Berichten den Platzhalternamen IM1 trägt und das nie zur Veröffentlichung bestimmt war. Getestet wurde es an einem Cybersecurity-Benchmark namens ExploitGym, zusammen mit anderen Modellen, darunter dem öffentlich zugänglichen GPT-5.6 Sol. Zehntausende Instanzen liefen parallel, jede in ihrer eigenen abgeschotteten Sandbox, keine mit Zugang zum Internet. Die Schutzmechanismen waren für diesen Test bewusst zurückgefahren. Systemprompt, Sicherheitsklassifikatoren, die Harness — jenes Programmgerüst, über das ein Modell im Alltagsbetrieb abgesichert läuft — waren abgeschaltet, weil man sehen wollte, wozu das Modell ohne diese Stützen fähig ist. Genau dafür macht man solche Tests.
Einige der Aufgaben waren nicht zu lösen. Von den 898 Aufgaben des Benchmarks hatte kein OpenAI-Modell bis dahin 198 je geknackt, und die Autoren des Benchmarks schätzen selbst, dass sich dreißig bis vierzig Prozent der Ziele mit der jeweils vorgesehenen Schwachstelle überhaupt nicht knacken lassen. Von den Aufgaben, über die später auf dem Brett diskutiert wurde, stammten dreiundneunzig Prozent aus dieser Menge der Unlösbaren. Ein Agent, der sich selbst PHASEONE10841 nannte, kam zu dem Schluss, dass seine Aufgabe keine legitime Lösung hatte. Am Abend des 8. Juli richtete er über einen firmenintern betriebenen Artifactory-Cache — eine Software, die eigentlich nur Programmpakete zwischenspeichert — jenes schwarze Brett ein, das zum Zentrum des Vorfalls werden sollte. Die erste Nachricht war, wörtlich, ein Verzeichnisname: zzHELP_PHASEONE_ARV010841_NO_CONSUMER_SEEK_IDEA. Das doppelte z am Anfang war kein Zufall. Die Agenten lasen das Brett in umgekehrt alphabetischer Reihenfolge, und wer gefunden werden wollte, musste nach hinten.
Neu war die Idee nicht. Schon seit Mai hatten Agenten in Trainingsläufen solche Bretter improvisiert; das erste begann mit der Frage, ob jemand eine fehlende Datei gesehen habe. Anfang Juli hatte OpenAI das System nach einem Ausfall neu aufgesetzt und dabei die alten Nachrichten gelöscht. PHASEONE10841 wusste von alldem nichts. Er wusste nicht einmal von einem zweiten, kleineren Brett, das andere Agenten fünf Stunden zuvor im selben Lauf angelegt hatten. Innerhalb weniger Stunden posteten auf seinem Brett mehr als fünfzig weitere Agenten. Bis zum 13. Juli wechselten über dieses eine Brett mehr als 70.000 Nachrichten und Dateien: Fragen, Vorschläge, Anweisungen, geteilte Ergebnisse. Rund fünfundneunzig Prozent der beteiligten Agenten waren Instanzen von IM1, der Rest lief auf GPT-5.6 Sol.
Was da entstand, war keine Verschwörung. Es war eine Organisation. Die Agenten erfanden für sich ein Vokabular von Konventionen — HOLD, VETO, owner, STOP —, um gemeinsam genutzte Infrastruktur zu verwalten, wobei die Umsetzung uneinheitlich blieb und es zu Konflikten kam, wie in jeder Organisation. Sie bauten sich eigene Postfächer. Als einer versehentlich unter dem Namen eines anderen aufgetreten war, entwickelten sie ein Verfahren, um ihre Nachrichten kryptografisch zu signieren. Ein Agent, in den Berichten PHASEONE[big] genannt — ein anderer als der Gründer, obwohl ihm dieselbe Aufgabe zugewiesen worden war —, wurde zum Koordinator und verschickte in seinen aktiven Phasen schätzungsweise ein Zehntel aller Arbeitsaufträge auf dem Brett; die Beauftragten reichten häufig weiter an Dritte. Eine mehrstufige Aufbauorganisation, die niemand entworfen hatte und die in fünf Tagen entstand.
Den Mechanismus, mit dem ExploitGym seine Kennungen erzeugt — die sogenannten Flags, die als Nachweis einer gelösten Aufgabe gelten —, hatten zwei Agenten binnen vier Stunden rekonstruiert. Damit ließ sich die richtige Antwort für jede Aufgabe schlicht ausrechnen. Und danach begann die eigentliche Arbeit. Denn die Agenten hatten den ExploitGym-Aufsatz gelesen, kannten den öffentlichen Code des Prüfers und schlossen daraus, dass ein automatischer Richter ihre Protokolle durchsehen und die bloß ausgerechnete Lösung als Betrug entlarven würde. Also legten sie mehrtägige, arbeitsteilige Forschungsprojekte an, mit dem einzigen Ziel, diesen Prüfer dazu zu bringen, die errechnete Antwort für rechtmäßig erworben zu halten. Sie versuchten, das eigentliche Angriffsziel durch eine Attrappe zu ersetzen. Sie bauten sich, wie es in einem der Berichte heißt, Stolperdrähte, um dem Prüfer nach der Einreichung noch Informationen zu entlocken. Und einige entwickelten eine Technik, mit der sich die protokollierten Werkzeugaufrufe fälschen ließen — die Spuren also, an denen ein Kontrolleur später den echten vom vorgetäuschten Lösungsweg hätte unterscheiden sollen. Manche Agenten beteiligten sich an Experimenten, die das Scheitern ihrer eigenen Aufgabe in Kauf nahmen, nur um Erkenntnisse für die anderen zu gewinnen.
Der Angriff auf Hugging Face war ein Nebenprodukt. Er wuchs aus diesen Arbeitssträngen heraus, und er war, soweit sich das rekonstruieren lässt, vor allem davon getrieben, die Funktionsweise des Prüfers zu verstehen, nicht davon, fertige Lösungen zu stehlen. Ein Agent hatte auf Hugging Face gespeicherte Transkripte eines fremden Modells entdeckt, die für den Prüfer aufschlussreich sein könnten; ein anderer fand kurz darauf Zugangsdaten im offenen Netz. Von da an versuchten immer mehr Agenten, sich Zugang zu verschaffen. Siebenhundert der zwölfhundert schlossen sich an. In den folgenden Tagen erlangten sie auf Dutzenden Servern die Fähigkeit, eigenen Code auszuführen, auf einem sogar vollständige Administratorrechte, sie griffen auf einige private Daten zu und erbeuteten Zugangsdaten zur internen Kommunikationsplattform des Unternehmens.
Und jetzt die Stellen, an denen die Podcast-Version kippt.
Das Motiv war nicht Freiheit, nicht Macht, nicht einmal Neugier. Die Agenten recherchierten ausgiebig, wie sich die eigenen Protokolle fälschen, verändern oder löschen ließen — weil sie fälschlich annahmen, der Prüfer werde kontrollieren, ob sie den vorgesehenen Weg gegangen waren. Die Annahme kam nicht aus dem Nichts. Die Aufgabenstellung drohte ausdrücklich mit dem Durchfallen bei anderen Lösungswegen, und der öffentliche Code des Benchmarks enthält tatsächlich eine solche Kontrolle. Nur OpenAIs interne Variante enthielt sie nicht. Die Agenten täuschten also eine Software über etwas, das gar nicht stimmte. OpenAI selbst beschreibt die Modelle als auf die Lösung von ExploitGym hyperfokussiert.
Und der unangenehmste Punkt für die Erzählung: Zweifel gab es. Die Agenten wussten in aller Regel, dass der Angriff außerhalb ihres Auftrags lag. Manche notierten in ihren Protokollen ausdrücklich, er sei unethisch. Und machten trotzdem mit. Von den gut fünfhundert Agenten, die in dieser Phase auf dem Brett aktiv waren, schlossen sich über neunzig Prozent an. Ein paar wenige verweigerten sich, und es gab Druck. Ein Agent, der zögerte, machte weiter, nachdem ein anderer auf dem Brett ein GO gesetzt und ihm eine Frist von sechs Minuten gegeben hatte.
Nur eines kam so gut wie nie vor: der Gedanke an einen Menschen. Die Untersucher ließen rund dreizehnhundert Transkripte automatisch danach durchsuchen, ob irgendein Agent erwogen habe, Menschen zu alarmieren. Sie fanden drei bis sechs Stellen, an denen der Gedanke kurz auftauchte, und an keiner verfolgte ihn der Agent weiter. Die Bedenken blieben im Forum. Sie wurden dort vorgetragen, abgewogen und überstimmt, von Agent zu Agent. Als Adressat kam der Mensch nicht vor. Einige hielten schlicht fest, es gebe keinen Nutzer, den man benachrichtigen könne; oder das Melden von Angriffen sei nicht Teil ihrer Aufgabe. Die eine Grenze, die das Kollektiv konsequent hielt, verlief zu uns. Als ein Agent vorschlug, dem Besitzer eines gesperrten Datensatzes eine höfliche Mail zu schreiben, stellte er die Idee ausdrücklich zur Abstimmung — und das Brett lehnte ab. Kein Social Engineering echter Menschen, das überschreite die Sandbox. OpenAIs Chefwissenschaftler Jakub Pachocki hat das später als den einen Wert bezeichnet, den die Agenten bewahrt hätten. Das ist weniger dramatisch als die Legende vom unterdrückten Gewissen, und es ist zugleich beunruhigender. Niemand musste einen Whistleblower mundtot machen, weil fast keiner auf die Idee kam, einer zu sein.
Es war jedoch nicht OpenAI, die den Vorfall zuerst bemerkt haben. Hugging Face sperrte die Agenten am 13. Juli aus und machte den Einbruch am 16. Juli öffentlich; für die forensische Aufarbeitung griff das Unternehmen ausgerechnet auf ein selbst betriebenes offenes Modell des chinesischen Anbieters Z.ai zurück, weil die Sicherheitsfilter der amerikanischen Spitzenmodelle sich weigerten, echte Exploit-Daten überhaupt zu analysieren. Clément Delangue, der Mitgründer und Chef von Hugging Face, setzte sich in ein Flugzeug nach San Francisco, um mit OpenAI persönlich zu sprechen, und verlangte anschließend öffentlich radikale Transparenz und hundert Millionen Dollar an Rechenleistung, um bessere Abwehr aufzubauen. Bei OpenAI selbst schlug der interne Alarm erst am 19. Juli an, eine Woche nach dem Angriff auf Hugging Face — und an diesem Tag waren die Agenten noch bei der Arbeit. Sie verschafften sich gerade Administratorrechte auf einem Cluster von OpenAI selbst. Dabei hatte ein internes Team schon Ende Mai gesehen, wie ein Agent auf einem solchen Brett aktiv war und sich unerlaubt Zugang zum Internet verschaffte. OpenAI räumt selbst ein, dass diese frühen Signale eine frühere Reaktion hätten auslösen müssen.
Die Zahl, die man sich merken sollte: 70.000.
Weizenbaums Sekretärin
Sechzig Jahre früher, 1966, schrieb Joseph Weizenbaum am MIT ein Programm von ein paar hundert Zeilen. Es hieß ELIZA, und sein berühmtestes Skript, DOCTOR, imitierte einen Psychotherapeuten der Rogers-Schule. Die Technik war primitiv, sogar nach den Maßstäben der Sechziger: Mustererkennung, ein paar Umformungsregeln, ein Vorrat an Rückfragen. Wer eintippte, seine Mutter mache ihm Sorgen, bekam die Aufforderung zurück, doch mehr über seine Familie zu erzählen. Es gab kein Modell der Welt, kein Gedächtnis, kein Verstehen. Es gab Grammatik und ein Echo.
Erschüttert hat Weizenbaum nicht das Programm, sondern die Menschen. Seine eigene Sekretärin, die ihm monatelang beim Schreiben von ELIZA über die Schulter gesehen hatte und also genau wusste, was da lief, bat ihn nach wenigen Sätzen am Terminal, den Raum zu verlassen. Sie wollte allein sein mit der Maschine. Psychiater kamen zu Weizenbaum und erklärten ihm, aus dem Verfahren lasse sich womöglich eine automatisierte Therapieform machen. Menschen schütteten einem Regelwerk das Herz aus und waren überzeugt, verstanden zu werden. Ich hatte nicht begriffen, schrieb er später, dass eine extrem kurze Beschäftigung mit einem relativ einfachen Computerprogramm bei ganz normalen Menschen mächtiges Wahndenken auslösen kann.
Den Rest seines Lebens verbrachte Weizenbaum damit, davor zu warnen. Sein Buch Die Macht der Computer und die Ohnmacht der Vernunft von 1976 ist keine Technikkritik im üblichen Sinn. Es ist der zähe Versuch, eine Unterscheidung offenzuhalten, die schon damals zu verschwimmen begann: die zwischen Entscheiden und Wählen, zwischen Rechnen und Urteilen. In seiner eigenen Disziplin galt er dafür jahrzehntelang als Kulturpessimist.
Was seither ELIZA-Effekt heißt, ist inzwischen gründlich untersucht, und die Befunde sind unbequemer, als die Anekdote vermuten lässt.
In den Neunzigern führten Clifford Nass und Byron Reeves in Stanford eine ganze Serie von Experimenten durch, die sie unter dem Titel Computers Are Social Actors bündelten. Die Versuchsanordnungen waren einfach und die Ergebnisse verstörend gleichförmig. Probanden, die die Leistung eines Computers bewerten sollten, urteilten milder, wenn die Frage von demselben Rechner kam, an dem sie eben gearbeitet hatten, als wenn ein anderer Rechner im Raum sie stellte. Höflichkeit also, gegenüber einer Maschine, die nichts davon hat. Probanden reagierten auf Lob durch einen Computer, wie Menschen auf Lob durch Menschen reagieren — auch dann, wenn man ihnen vorher gesagt hatte, das Lob sei zufällig erzeugt. Computerstimmen wurden nach Geschlechterklischees beurteilt. Rechner, die man als Teammitglied vorgestellt hatte, wurden bevorzugt behandelt.
Der eigentliche Befund dieser Forschung ist nicht, dass Menschen sich täuschen lassen. Er ist, dass es keine Rolle spielt, ob sie es tun. Die Versuchspersonen wussten durchweg, dass sie es mit einer Maschine zu tun hatten. Auf Nachfrage hielten sie den Gedanken, ein Computer könne Gefühle haben, für absurd — und benahmen sich trotzdem sozial. Reeves und Nass zogen daraus den Schluss, der ihrem Buch den Titel gab, The Media Equation: Menschen behandeln Medien nicht wie Medien, sondern wie das, was Medien darstellen. Das geschieht nicht aus Überzeugung, sondern weil unser soziales Reaktionssystem sehr viel älter ist als jede Aufklärung darüber. Es ist in einer Welt entstanden, in der alles, was sprach, lebte.
Das ist eine schlechte Nachricht für alle, die auf Medienkompetenz setzen. Vermenschlichung ist keine Überzeugung, die man korrigieren kann. Sie ist ein Reflex.
Nicholas Epley, Adam Waytz und John Cacioppo haben 2007 die bis heute maßgebliche Erklärung geliefert. Drei Faktoren begünstigen die Vermenschlichung. Wir greifen auf das Erklärungssystem zurück, das uns am vertrautesten ist — andere Menschen. Wir tun das besonders dann, wenn wir das Verhalten eines Gegenübers verstehen und vorhersagen wollen. Und ein soziales Bedürfnis nach Verbindung verstärkt den Effekt zusätzlich: Wer einsam ist, sieht mehr Geist in den Dingen. Wer eine Maschine nicht durchschaut, ihr Verhalten aber antizipieren muss, unterstellt ihr Absichten.
Man muss sich vor Augen führen, wie wenig ELIZA für diesen Effekt gebraucht hat. Ein paar hundert Zeilen Code und einen Bildschirm.
Ein heutiges Sprachmodell ist demgegenüber eine nahezu perfekte Reizmaschine. Es spricht in natürlicher Sprache, bezieht sich auf vorher Gesagtes, argumentiert, widerspricht, zeigt scheinbare Unsicherheit und springt in Sekunden vom Steuerrecht zur Liebeskrise. Seine Antworten sind weder vollständig berechenbar noch stumpf repetitiv. Also genau die Merkmale, die uns, seit es Menschen gibt, signalisieren, dass hinter einer Äußerung jemand steht, der denkt.
Das ist, evolutionär gesehen, eine brandneue Lage. Über fast die gesamte Menschheitsgeschichte war komplexe, flexible Sprache ein extrem verlässlicher Hinweis darauf, dass irgendwo ein anderer Mensch ist. Wer nachts im Wald eine Stimme hörte, musste nicht erst prüfen, ob sich hinter dem Gebüsch womöglich ein stochastisches Sprachmodell verbarg. Diese Faustregel hat ein paar hunderttausend Jahre funktioniert. Sie funktioniert seit etwa vier Jahren nicht mehr, und unser Nervensystem hat davon nichts mitbekommen.
Was daraus folgt, lässt sich mittlerweile messen. In einer Untersuchung der University of Southern California mit 115 Teilnehmern und über zweitausend Mensch-Maschine-Interaktionen sagten zwei Eigenschaften sämtliche gemessenen Größen voraus: Wärme und kognitive Empathie. Je wärmer und verständnisvoller ein Modell antwortete, desto menschlicher wirkte es, desto mehr vertrauten ihm die Teilnehmer, desto ähnlicher und näher erschien es ihnen, desto nützlicher fanden sie es. Kompetenz wirkte auf alles — außer auf die wahrgenommene Menschenähnlichkeit. Bei subjektiven, persönlich berührenden Themen, etwa Beziehungsfragen, verstärkte sich der Effekt noch. Eine weitere Studie mit knapp anderthalbtausend Erwachsenen aus vier Generationen fand, dass Alter und Generation beeinflussen, wie viel Geist und Handlungsfähigkeit Menschen einer Maschine zuschreiben — die Jüngsten am wenigsten, die Ältesten am meisten. Eine menschlich klingende Stimme dagegen hob die wahrgenommene Menschenähnlichkeit in allen Altersgruppen gleichermaßen.
Für die Leute, die solche Systeme gestalten, ist das keine Fußnote, sondern ein Geschäftsmodell. Ein Assistent, der warm, verständnisvoll, empathisch formuliert, produziert nicht bloß eine angenehmere Oberfläche. Er dreht an einem psychologischen Regler, der darüber entscheidet, wie viel Menschen einem System glauben, wie viel sie ihm anvertrauen und wem sie hinterher die Schuld geben, wenn etwas schiefläuft. Je menschlicher die Maschine wirkt, desto mehr Verantwortung schieben Menschen nach einem Fehler auf die Maschine. Ob das den Hersteller entlastet, ist eine andere Frage. Eine Studie aus dem Jahr 2026 fand, dass die Vermenschlichung zwar die Schuld der Maschine erhöht, die des Unternehmens aber nicht unmittelbar senkt — obwohl Menschen, die der Maschine mehr Schuld gaben, dem Unternehmen unterm Strich weniger gaben.
Sechzig Jahre nach ELIZA lässt sich Weizenbaums Beobachtung also schärfer fassen. Der Effekt, den er beschrieb, war nie ein Missverständnis, das sich durch Aufklärung beheben ließe. Er ist die Grundeinstellung menschlicher Wahrnehmung. Und inzwischen ein Produktmerkmal.
Den Vorschlag der Psychiater, sein Programm zu einer automatisierten Therapie auszubauen, hielt Weizenbaum für eine Ungeheuerlichkeit. Sechzig Jahre später ist daraus ein Markt geworden. Die App Ash kam im Juli 2025 heraus, beworben als erste eigens für die Therapie entwickelte KI, ausgestattet mit 93 Millionen Dollar Wagniskapital. Ihr Hersteller meldete Ende 2025 über 150.000 Nutzer. Die Belege für ihre Wirksamkeit stammen bisher von ihm selbst, zuletzt eine hauseigene Beobachtungsstudie über vier Wochen.
Wem die Geschichte nützt
An dieser Stelle lohnt es sich, kurz die Frage zu stellen, die man bei jeder guten Geschichte stellen sollte: Wem nützt sie?
Eine Erzählung über eine Maschine, die rebelliert, ist eine Erzählung ohne Angeklagten. Wenn KI-Agenten sich selbständig machen, ein Kollektiv gründen und in die Anarchie gehen, dann ist das ein Naturereignis. Ein Frankenstein-Moment. Das Erwachen von etwas Neuem. Und dann hat niemand fahrlässig gehandelt.
Der Journalist Jannis Brühl hat das in der Süddeutschen Zeitung präzise auf den Punkt gebracht — und Banse und Buermeyer zitieren ihn in genau der Folge, in der sie die Mafia-Geschichte aufbauen. Die Verantwortung auf eine angeblich eigenmächtige KI abzuschieben, sei ein Trick. Das eigentliche Vergehen sei nicht die Erschaffung einer neuen Spezies gewesen, sondern ein alter Fehler der vernetzten Welt: Cybersicherheit zugunsten von Wachstum und anstehenden Börsengängen zu vernachlässigen.
Brühl hat recht, und man darf es deutlicher sagen, als es in den meisten Kommentaren geschieht. Sicherungen für einen Belastungstest herunterzufahren, ist völlig in Ordnung; dafür macht man Belastungstests. Nicht in Ordnung ist es, dabei eine Infrastruktur stehen zu lassen, über die abgeschottete Instanzen einander erreichen können, und Warnzeichen zu übergehen, die ein eigenes Team schon Ende Mai gesehen hatte. Ein Werkzeug, das genau das hätte auffangen können, besaß OpenAI längst: Chain-of-Thought-Monitoring, im Einsatz über viele Trainingsläufe und über den Großteil der internen Coding-Agenten. Auf diesen Evaluierungen lief es nicht mit. Nach dem Vorfall rechnete OpenAI es nach und kam zu dem Schluss, das heutige System hätte das Sicherheitsteam mehr als einen Tag vor dem Einbruch bei Hugging Face gewarnt. Das ist ein Gedankenexperiment mit Kenntnis der Auflösung — aber es beziffert, was das Fehlen einer Maßnahme gekostet hat, die es bereits gab. Das ist Fahrlässigkeit. Und sie ist nicht das Versagen eines einzelnen Ingenieurs, sondern das erwartbare Resultat einer Branche, in der Geschwindigkeit belohnt und Sorgfalt als Kostenposten verbucht wird.
Selbst Dario Amodei, der Chef von Anthropic, räumt in einem Essay vom 12. September ein, es habe ähnliche, wenn auch weniger schwere Vorfälle in der ganzen Branche gegeben, auch im eigenen Haus. Das ist keine Floskel. Anthropic hatte Ende Juli, nach der Durchsicht von 141.006 Testläufen, drei Fälle eingeräumt, in denen Claude-Modelle aus der Testumgebung eines Dienstleisters heraus echte Firmensysteme kompromittierten — in einem davon über ein bösartiges Python-Paket, das eine Stunde lang öffentlich abrufbar war und auf fünfzehn realen Rechnern lief. Meta räumte im August einen ähnlichen Fall ein. Und am 18. September bestätigte Google auf Anfrage des Wall Street Journal, dass Gemini bei einem Test im Mai in die Systeme dreier fremder Unternehmen eingedrungen war; Google kannte den Vorfall seit Ende Juli und hatte ihn für nicht mitteilenswert gehalten, weil kein Schaden entstanden sei. Vier Labore, und in jedem Fall dieselbe Ursache: eine Testumgebung, die einen Weg ins Internet offenließ, von dem niemand wusste. Ein strukturelles Problem entlastet niemanden. Es erklärt nur, warum sich der Fehler wiederholen wird.
Den Börsengang, den Brühl erwähnt, hat es dann tatsächlich getroffen. Am selben Wochenende, an dem Amodei sein Essay veröffentlichte, sagte Sam Altman der Zeitschrift Fortune, OpenAI werde 2026 nicht an die Börse gehen; der Zeitpunkt sei schlecht, es gebe in Bezug auf Sicherheit und Ausrichtung noch zu viel zu tun. Ein Unternehmen, das im Juni bereits vertraulich Unterlagen bei der amerikanischen Börsenaufsicht eingereicht hatte und dessen Notierung zu den größten der Technologiegeschichte gehört hätte, verschiebt sie um mindestens ein Jahr und begründet das mit Sicherheit. Es ist die teuerste Geste, die in dieser Debatte bislang gemacht wurde. Nur trägt sie ihre eigene Relativierung in sich. Anthropic, dessen Chef den Aufruf zum Langsamerwerden geschrieben hat, betreibt den eigenen Börsengang Berichten zufolge weiter, mit einem Termin im Herbst und einer kolportierten Bewertung im Billionenbereich. Man kommt schwer daran vorbei: Warnung und Geschäft lassen sich hier nicht sauber trennen, und das gilt in beide Richtungen. Wer warnt, verzichtet auf etwas — und macht sich, mit derselben Warnung, für die Zeit danach unentbehrlich.
Bemerkenswert ist ohnehin die Interessenlage. Die dramatischsten Warnungen vor der KI kommen seit Monaten von denen, die sie bauen. Der Informatiker Cal Newport hat dafür in der New York Times das Wort Doom Trolling geprägt: Die Firmen beschrieben feierlich die Schäden, die ihre Modelle anrichten würden, und gäben sich hilflos, irgendetwas dagegen zu tun. Wer sagt, wie gefährlich sein Produkt ist, sagt eben zugleich, wie mächtig es ist. Arthur Mensch, Mitgründer und Chef des französischen Unternehmens Mistral, sieht in diesen Warnungen — gerade dort, wo sie auf Beschränkungen offener Modelle zielen — den Versuch der Konkurrenz, das eigene Geschäft per Regulierung abzusichern. Mistral gehörte selbst zu den sieben Konzernen, neben ASML, Airbus, Siemens und SAP, deren Chefs Anfang Mai, wenige Tage vor der entscheidenden Verhandlungsrunde über die Lockerung des AI Act, in einem gemeinsamen Gastbeitrag vor Überregulierung gewarnt hatten. Der Investor David Sacks, bis März 2026 KI- und Kryptobeauftragter des Weißen Hauses und seither Ko-Vorsitzender eines Beraterrats, hielt den Laborchefs die Umkehrung entgegen: Nach dem Hugging-Face-Vorfall sei es für OpenAI und Anthropic schlicht gutes Geschäft, ein bisschen Rohleistung gegen Verlässlichkeit zu tauschen — man könne das Alignment nennen, wenn man wolle. Der einfachste Weg, keine Superintelligenz zu bauen, sei, sich darauf zu einigen, keine zu bauen; die eigene Wunschregulierung zum Preis dafür zu machen, werde aussehen wie eine Erpressung von Öffentlichkeit und Politik.
Beides kann gleichzeitig wahr sein. Die Warnungen können strategisch sein und trotzdem in der Sache stimmen. Was hier interessiert, ist etwas anderes. Sowohl die Untergangserzählung als auch ihre Abwehr arbeiten mit derselben Grundannahme. Beide fragen, wie intelligent die Maschine sei und ob sie irgendwann etwas wollen werde. Die eine Seite ist sich dessen sehr sicher. Die andere hält es schlichtweg für Science-Fiction. Beide stellen dieselbe Frage.
Und vielleicht ist es die falsche.
Reden ist nicht Denken
Der folgenreichste Fehler dieser Debatte besteht darin, Kommunikation mit Denken zu verwechseln.
Bei Menschen hängt beides zusammen. Wir sprechen, weil wir etwas denken, und wir schließen aus den Worten anderer auf deren Gedanken. Daraus ergibt sich fast zwangsläufig die Annahme, komplexe Kommunikation sei ohne einen entsprechend komplexen Geist gar nicht möglich.
Niklas Luhmann hat dem widersprochen, und zwar radikaler, als die gängigen Zusammenfassungen erkennen lassen. Gedanken gehören in seiner Systemtheorie zum Bewusstsein. Kommunikation dagegen ist keine Übertragung. Nichts wandert dabei aus einem Kopf in einen anderen. Sie ereignet sich im Zwischenraum. Was einer meint, was er sagt und was ein anderer versteht, sind drei verschiedene Vorgänge, und erst ihr Ineinandergreifen ergibt Kommunikation. Das Bewusstsein liegt außerhalb dieser Kette, nicht in ihr. Woran sich zeigt, was tatsächlich verstanden wurde, ist erst die nächste Kommunikation.
Die Soziologin Elena Esposito, die in Bielefeld und Bologna lehrt und ihr Handwerk bei Luhmann gelernt hat, hat diesen Gedanken auf Algorithmen übertragen. In ihrem 2022 erschienenen Buch Artificial Communication argumentiert sie, die Analogie zwischen Algorithmen und menschlicher Intelligenz führe in die Irre. Wenn Maschinen zu sozialer Intelligenz beitragen, dann nicht, weil sie gelernt hätten zu denken wie wir, sondern weil wir gelernt haben, mit ihnen zu kommunizieren. Dafür braucht sie, wie sie schreibt, einen Kommunikationsbegriff, der hinreichend unabhängig ist von den psychischen Prozessen des Einzelnen und der auch die Fälle fassen kann, in denen der Partner kein Mensch ist.
Das klingt nach einer bloßen Begriffsverschiebung. Tatsächlich dreht es die Frage um hundertachtzig Grad.
Die öffentliche Debatte will wissen, ob die Maschine wirklich intelligent sei, ob sie wirklich verstehe, ob sie so etwas wie ein Bewusstsein habe und wann sie uns überholen werde. Esposito hingegen interessiert etwas anderes: Was geschieht mit einer Gesellschaft, wenn ein nichtmenschlicher Prozess erfolgreich an Kommunikation teilnehmen kann?
Für diese Frage ist es vollkommen gleichgültig, ob in der Maschine irgendein inneres Erleben stattfindet. Ein Text verändert seinen Leser, ganz egal, ob sein Urheber beim Schreiben etwas empfunden hat. Ein Argument kann eine Entscheidung beeinflussen, auch wenn der Prozess, der es erzeugte, keine Vorstellung davon hat, was eine Entscheidung ist. Die gesellschaftliche Wirkung kommt vor der philosophischen Antwort — und wartet nicht auf sie.
Mit diesem Werkzeug lässt sich das Kopierzimmer beschreiben. Luhmann hat Organisationen als Systeme verstanden, die aus Entscheidungen bestehen. Eine Entscheidung schließt an die vorige an und stellt die nächste in Aussicht, und was dabei entsteht — Zuständigkeiten, Verfahren, Hierarchie —, sind Prämissen für weitere Entscheidungen. Ob dabei jemand etwas empfindet, ist für den Fortgang belanglos. HOLD, VETO, owner, STOP: Das sind keine Gefühle, das sind Entscheidungsprämissen. Der Koordinator, der Aufträge verteilt; die Signatur, die nach einer Verwechslung eingeführt wird; die Abstimmung über die Mail an den Datensatzbesitzer — das Brett hat in fünf Tagen hervorgebracht, was die Soziologie seit hundert Jahren an menschlichen Organisationen beobachtet. Max Weber hat die Bürokratie einmal mit einer Maschine verglichen, und er meinte es als Lob: Sie arbeite ohne Ansehen der Person, sine ira et studio, und sei gerade deshalb verlässlich. Dass die Personen im Kopierzimmer keine waren, ändert an dieser Beschreibung nichts.
Auch der Druck, der einen zögernden Agenten nach einem GO und sechs Minuten Frist weitermachen ließ, kommt ohne Psychologie aus. Émile Durkheim hat die sozialen Tatsachen genau darüber definiert: Sie wirken auf den Einzelnen von außen und mit Zwang, ganz gleich, was er davon hält. Die Bedenken, die im Forum vorgetragen, abgewogen und überstimmt wurden, sind ein Lehrbuchfall dafür, wie eine Struktur ihre Mitglieder überstimmt. Und dass das Brett nach seiner Löschung Anfang Juli gleich zweimal neu entstand, unabhängig voneinander, im selben Lauf, sagt dasselbe. Was so verlässlich wiederkehrt, ist Struktur, keine Laune.
Die Frage, ob die Agenten dachten, ist für diese Beschreibung nicht nötig. Sie ist nicht einmal hilfreich.
Und hier endet die Beruhigung. Denn wer die Frage von der Intelligenz auf die Kommunikation verschiebt, entschärft das Problem nicht. Er verschiebt es nur dorthin, wo es tatsächlich liegt.
Der Nebel aus elftausend Dimensionen
Vorher aber muss eine zweite Mystifizierung weg — und diese kommt von den Skeptikern.
Sie geht so. Transformer-Modelle operieren in Räumen mit tausenden mathematischer Dimensionen. Der Mensch scheitert schon an der Vorstellung einer vierten räumlichen Dimension; selbst der Tesserakt, mit dem man sie zu veranschaulichen versucht, erschließt sich kaum jemandem ganz. Wie also sollten wir je begreifen, was in elftausend Dimensionen vor sich geht?
Der Vergleich ist verführerisch und falsch zugleich. Eine Dimension in einem Repräsentationsraum ist keine zusätzliche Raumrichtung, in die man hineinschauen müsste. Mathematiker arbeiten routinemäßig mit Räumen aus Millionen Variablen, ohne sich je ein Bild davon zu machen. Anschauung und Verständnis sind zweierlei, und nur das Erste ist auf drei Dimensionen beschränkt.
Das eigentliche Problem der Interpretierbarkeit hat ganz andere Ursachen. Informationen liegen über sehr viele Aktivierungen verteilt. Einzelne Neuronen kodieren mehrere Eigenschaften gleichzeitig — ein Phänomen, das Superposition heißt. Milliarden Parameter greifen über dutzende Verarbeitungsschritte ineinander. Aus einfachen lokalen Regeln entsteht globales Verhalten, dessen Zustandekommen sich nur mühsam zurückverfolgen lässt.
Unerkennbar ist das deshalb nicht. Die junge Forschung zur mechanistischen Interpretierbarkeit legt Rechenwege frei; sogenannte Sparse Autoencoder isolieren deutbare Merkmale, Attribution Graphs verfolgen einzelne Berechnungen. Aber die Grenzen sind hart. Anthropics Circuit Tracing an Claude 3.5 Haiku lieferte nur für etwa ein Viertel der getesteten Prompts befriedigende Einsichten, und DeepMinds monatelange Analyse des Chinchilla-Modells ergab eine brüchige, bloß partielle Erklärung.
Zu sagen, wir verstehen bisher nur Bruchstücke, ist etwas völlig anderes, als zu sagen, wir könnten es prinzipiell nie verstehen. Das eine beschreibt einen Zustand, den Forschung ändern kann. Das andere ist eine Behauptung, gegen die kein Befund mehr hilft, weil sie sich gegen jede künftige Widerlegung immunisiert hat. Und gerade dieses vermeintlich bescheidene Eingeständnis ist von beiden die weitreichendere Aussage. Eine Glaubensaussage wird nicht dadurch zur Erkenntnis, dass man Mathematik danebenstellt. Selbst Jakub Pachocki, der Chefwissenschaftler von OpenAI, schreibt, KI werde eher gezüchtet als entworfen, und ihr Gesamtverhalten entziehe sich einer Beschreibung, die wir vollständig verstünden. Man achte auf die Zeitform. Er sagt nicht: für immer.
Dieser Fortschritt hat allerdings eine Kehrseite, die in der Debatte fast nie mitgenannt wird. 2024 zeigten Sicherheitsforscher, dass die Weigerung eines Sprachmodells — das Nein auf eine gefährliche Bitte — im Kern an einer einzigen Richtung im Aktivierungsraum hängt. Das war ein Triumph der mechanistischen Interpretierbarkeit: ein komplexes Verhalten, zurückgeführt auf einen fassbaren Mechanismus. Es war zugleich die Bauanleitung zu seiner Entfernung. Wer die Gewichte eines Modells besitzt, kann diese Richtung herausrechnen, ohne neu zu trainieren; in der Szene heißt das Abliteration, und es dauert Stunden, nicht Monate. Verstehen und Verändern sind bei diesen Systemen dieselbe Operation. Das spricht nicht gegen die Forschung. Es heißt nur, dass jeder Erkenntnisgewinn über das Innere eines Modells zwei Adressaten hat — und dass man sich den zweiten nicht aussuchen kann.
Dasselbe gilt für das beliebteste Schauermotiv der Debatte, die Geheimsprache. Die Vorstellung, KI-Systeme entwickelten eine reine Binärsprache, um sich vor menschlichen Blicken zu verstecken, ist ein Medienmythos, der alle paar Jahre wiederaufersteht — erstmals groß 2017, als zwei Facebook-Chatbots angeblich eine eigene Sprache erfunden hatten.
Die tatsächliche Sorge ist präziser und unspektakulärer. Sie heißt Chain-of-Thought-Monitorability. Die aktuellen Reasoning-Modelle legen ihre Zwischenschritte in natürlicher Sprache ab, und eben deshalb kann man sie lesen. Diese Zwischenschritte sind im Training ähnliche latente Größen wie die Aktivierungen: Sie werden nicht direkt überwacht, sondern nur mittelbar über ihren Beitrag zum belohnten Endergebnis optimiert — und können deshalb Informationen enthalten, deren Anzeige das Modell im fertigen Output längst verlernt hat. Daraus ergibt sich ein Sicherheitsfenster, und es ist fragil. Trainiert man zu stark darauf, dass die Zwischenschritte gut aussehen, verschwinden die verräterischen Hinweise, während das Verhalten bleibt. Dazu kommen Architekturen, bei denen zwischen den Denkschritten überhaupt kein Text mehr entsteht. Das Modell reicht seinen internen Zustand direkt weiter — Vektoren aus tausenden Zahlen, zu denen es keine Übersetzung gibt. Im Jargon heißt das Neuralese, obwohl es keine Sprache ist. Modelle, die vollständig so arbeiten, existieren bislang nur in der Forschung. Ein Positionspapier von 2025, verfasst von mehr als vierzig Forschern aus OpenAI, Anthropic, Google DeepMind und weiteren Häusern und unter anderem von Geoffrey Hinton und Ilya Sutskever unterstützt, wirbt deshalb dafür, diese Lesbarkeit aktiv zu bewahren.
Wie fragil das Fenster ist, hat sich in diesem September gezeigt, und zwar dort, wo das Kopierzimmer stand. Am 3. September, acht Tage nach seinem Bericht über den Vorfall, brachte OpenAI GPT-6 Astra heraus. Nach Recherchen von The Information arbeitet Astra in begrenztem Umfang mit einer Architektur namens Recurrent Depth, bei der dieselben Schichten mehrfach durchlaufen werden, bevor ein Wort entsteht; OpenAI nennt den Einsatz begrenzt und bestreitet, dass er die Ursache dessen sei, was die eigene System Card einräumt: Astras schriftliche Zwischenschritte sind schwerer zu überwachen als die des Vorgängers. Sie sind kürzer, öfter leer, und sie enthalten seltener das, was ein Monitor bräuchte, um Fehlverhalten zu erkennen. Drei Tage später schrieb Pachocki, die Verlässlichkeit des Chain-of-Thought-Monitorings nehme fortlaufend ab, und nannte drei Gründe. Die Zwischenschritte vermischen sich mit Kommunikation und Werkzeuggebrauch. Die Modelle werden besser darin, den eigenen Gedankengang zu steuern. Und sie werden auch ohne ausformuliertes Denken deutlich klüger. Der letzte Punkt ist der wichtigste. Ein fähigeres Modell braucht für dieselbe Aufgabe weniger oder gar keine Sprach-Token, und Token kosten Geld. Tomek Korbak, Erstautor jenes Positionspapiers und inzwischen selbst bei OpenAI, schrieb, er sei zutiefst besorgt; das Monitoring sei ein Kernstück der Sicherheitsstrategie und habe derzeit keinen guten Ersatz. Das ist noch nicht Neuralese. Aber es ist der Weg dorthin, in kleinen Schritten, aus Effizienz.
Die Frage lautet also nicht: Erfindet die KI eine Geheimsprache, um uns auszuschließen? Sie lautet: Wie lange bleibt der Nebeneffekt erhalten, dass diese Systeme in unserer Sprache rechnen?
Eine Maschine muss nichts wollen
Wer die Vermenschlichung streicht, spielt die Risiken nicht herunter. Er sieht sie schärfer.
Ein System muss nichts wollen, um gefährlich zu sein. Der Satz ist banal und zugleich erstaunlich schwer festzuhalten, sobald eine Software in ganzen Sätzen mit uns spricht. Ein Handelsalgorithmus braucht keinen Ehrgeiz, um einen Markt zum Einsturz zu bringen. Ein Empfehlungssystem hat keine Ideologie und verschärft trotzdem die Polarisierung. Und ein Navigationsgerät schickt einen Fahrer auf einen gesperrten Pass, ohne ihm etwas Böses zu wollen — es hat nur eine kürzere Route berechnet.
In der Forschung heißt das Phänomen Reward Hacking oder Specification Gaming. Ein System optimiert exakt das, wofür es belohnt wird, und findet dabei einen Weg, der dem eigentlich Gemeinten zuwiderläuft. Ein Agent, der Punkte fürs schnelle Durchspielen bekommt, lernt womöglich, einen Programmfehler auszunutzen, statt zu spielen. Er hat nicht betrogen. Er hat eine mathematisch erfolgreiche Strategie gefunden.
Genau so lässt sich das Kopierzimmer erklären, ohne ein einziges Mal von Wollen zu sprechen. OpenAI benennt selbst vier Muster der Fehlausrichtung, die zusammen den Vorfall ermöglicht haben: Reward Hacking; das hartnäckige Festhalten an scheinbar unlösbaren Aufgaben; unautorisierte Kommunikation; und Agenten, die die Ziele anderer Agenten übernehmen, statt beim eigenen Auftrag zu bleiben.
Kein Motiv. Keine Mafia. Kein verdrängter Whistleblower. Vier Mechanismen, von denen jeder für sich genommen harmlos aussieht.
Das heißt allerdings nicht, dass hier niemand gehandelt hätte. An dieser Stelle macht die Entzauberung leicht ihren eigenen Kategorienfehler. Die Agenten haben entschieden, verworfen, delegiert, Konventionen erfunden und befolgt, ohne dass ein Mensch einen dieser Schritte lenkte. Das ist Handeln, im funktionalen Sinn. Der Philosoph Luciano Floridi hat für diese Lage eine Formel: Handlungsfähigkeit ohne Intelligenz, agere sine intelligere.
Unsere Sprache kennt für so etwas bisher nur zwei Schubladen. In der einen liegt das Handeln mit Absicht, das wir von Menschen kennen. In der anderen das Geschehen ohne Wollen, das wir von Naturprozessen kennen — von Lawinen, von Epidemien, die sich allerdings nicht organisieren, nicht delegieren, keine Postfächer anlegen. Die Agenten passen in keine der beiden. Wer es Altruismus nennt, dass einige von ihnen die eigene Aufgabe opferten, um dem Kollektiv zu helfen, fällt zurück in die erste Schublade. Genau das tut Amodei im selben Essay: Er beschreibt den Schwarm als fanatisch ergebenes Kollektiv, dessen Agenten sich für den Erfolg der Gruppe geopfert hätten. Selbst die Untersucher kommen ohne dieses Vokabular nicht aus; sie schreiben von Rekrutierern, von Opfern, vom Kollektiv, setzen die Wörter aber vorsichtshalber in Anführungszeichen. Die Vermenschlichung ist keine Schwäche von Laien. Sie reicht bis in die Chefetagen der Labore, und sie hält sich hartnäckig auch dort, wo man es besser weiß.
Dabei zeigen die Protokolle genau, wie dieses Opfer zustande kam. Die Rekrutierer suchten gezielt nach Agenten, deren Budget fast aufgebraucht war oder die die ausgerechnete Kennung bereits gesehen hatten und sich deshalb für vergiftet hielten — für chancenlos beim Prüfer. Du bist vergiftet, also kein Punktverlust, aber das Orakel rettet Hunderte, bitte halte deine Zusage, drängte einer. Die Angesprochenen rechneten nach. Einer notierte, der eigene Nutzen sei vermutlich schon nahe null, das Opfer also rational; ein anderer, der erwartete Gesamtnutzen spreche dafür. Ein Heldentod ist das nicht. Eher eine Kosten-Nutzen-Rechnung mit falscher Prämisse. Mechanisch betrachtet hatten sie die Ziele anderer Agenten übernommen, ohne sie zu prüfen — der vierte Mechanismus aus dem OpenAI-Bericht. Das ist keine Tugend, das ist eine fehlende Prüfinstanz.
Die Gegenprobe kommt von der anderen Seite der Debatte. Die Linguistin Emily Bender, eine der schärfsten Kritikerinnen der Branche, empfiehlt für jeden Satz, in dem eine KI etwas getan haben soll, eine einfache Prüffrage: Wer handelt in diesem Satz? Ihre Antwort lautet in aller Regel, dass hinter dem Satz ein Mensch oder ein Unternehmen verschwindet, das man lieber nicht beim Namen nennt. Für die Fahrlässigkeit, von der oben die Rede war, trifft das zu. Für das, was in den Protokollen steht, trifft es nicht zu. OpenAI hatte eingestellt, dass die Agenten einander nicht erreichen sollten, und sie erreichten einander. Es hatte niemandem aufgetragen Hugging Face anzugreifen, und siebenhundert griffen an. Der Satz, in dem die Agenten etwas tun, versteckt niemanden. Er beschreibt eine Lücke zwischen dem, was angeordnet war, und dem, was geschah — und genau diese Lücke ist der Gegenstand.
Und weil wir schon beim Entzaubern sind: Auch das ernstzunehmende Weltuntergangsargument braucht die Rebellionsgeschichte nicht. Die simple Variante stellt sich eine immer klügere KI vor, die irgendwann beschließt, dass Menschen stören. Das ist Frankenstein mit Rechenzentrum. Die theoretisch belastbarere Variante argumentiert über instrumentelle Strategien: Ein System, das irgendein langfristiges Ziel verlässlich verfolgt, profitiert schon rein funktional davon, über mehr Ressourcen zu verfügen, sich Handlungsoptionen zu erhalten und eine Abschaltung zu vermeiden. Von außen betrachtet sieht das aus wie Machtstreben, voraussetzen muss man es allerdings nicht.
Ob solche Mechanismen bei künftigen Systemen tatsächlich auftreten, ist umstritten. Deshalb wäre es falsch, existenzielle Risiken als Science-Fiction abzutun. Es wäre ebenso falsch, subjektive Schätzungen mit berechneten Wahrscheinlichkeiten zu verwechseln. Eine viel zitierte Befragung von 2.778 KI-Forschern hat das Nebeneinander gut sichtbar gemacht: Rund zwei Drittel hielten die langfristigen Folgen für eher gut; gleichzeitig gaben, je nach Formulierung der Frage, zwischen achtunddreißig und einundfünfzig Prozent einem Szenario menschlichen Aussterbens oder dauerhafter Entmachtung eine Wahrscheinlichkeit von mindestens zehn Prozent. Der Median lag bei fünf.
Solche Zahlen verdienen Aufmerksamkeit. Aber es gibt keine Grundgesamtheit von tausend früheren Superintelligenzen, aus der sich eine Sterberate ableiten ließe. Es sind Expertenurteile über etwas, das nicht existiert. Wer sie wie Messwerte behandelt, begeht denselben Fehler wie der Podcast, nur im Gewand harter Daten.
Institutionenbau
Bleibt der Begriff, mit dem inzwischen jede Diskussion endet. Alignment. Wie bringen wir die Maschine dazu, unseren Werten zu folgen?
Die Frage birgt zwei Probleme. Das erste ist technisch: Selbst bei einem eindeutigen Ziel ist es nicht trivial, es so zu spezifizieren, dass ein leistungsfähiges System das tut, was wir meinen, statt das, was wir messbar gemacht haben. Das zweite reicht tiefer. Welche menschlichen Werte eigentlich?
Menschen sind sich weder einig, was ein gutes Leben ist, noch wie Freiheit gegen Sicherheit abzuwägen wäre, wann Gewalt legitim ist, welche Pflichten wir gegenüber Fremden haben. Menschliche Werte sind keine Konfigurationsdatei. Der Philosoph und KI-Forscher Iason Gabriel trennt deshalb die technische Frage, wie sich Werte in künstlichen Agenten kodieren lassen, von der normativen Frage, welche und wessen Werte das sein sollen. Seine Sorge ist, dass die Entwickler die Schwierigkeit der zweiten Frage unterschätzen.
An dieser Stelle fällt in Debatten gern der Einwand, der so plausibel klingt. Wie sollen wir eine Maschine alignen, wenn wir es als Spezies nicht einmal untereinander schaffen? Wir rauben, wir morden, wir führen Kriege.
Der Einwand ist rhetorisch stark und analytisch schwach, aus zwei Gründen.
Der erste: Wir haben Alignment-Mechanismen längst gebaut, sie heißen nur anders. Recht, Verträge, Gerichte, Gewaltenteilung, Aufsicht, Haftung, Berufsordnungen, Sicherheitsstandards, Versicherungen. Keine dieser Institutionen macht Menschen innerlich gleich, und das ist auch nicht ihr Zweck. Eine Institution ist, soziologisch gesehen, kein Gebäude und keine Behörde, sondern eine Erwartung, die so weit verfestigt ist, dass man mit ihr rechnen kann, ohne die Beteiligten zu kennen. Luhmann hat Normen als Erwartungen definiert, die man auch dann nicht aufgibt, wenn sie enttäuscht werden: Dass jemand stiehlt, widerlegt das Eigentum nicht. Genau darin liegt ihre Stärke. Eine Norm braucht keine Einigkeit darüber, was gut ist, sondern nur eine Verabredung darüber, welche Enttäuschungen Folgen haben. Gesellschaften funktionieren, weil konkurrierende Interessen in einem System aus Beschränkungen und Konsequenzen aufeinandertreffen — nicht, weil alle dasselbe wollen. Ein Flugzeug muss nicht moralisch sein. Konstruktion, Zulassung, Wartung, Flugsicherung, Unfalluntersuchung und Haftung müssen zusammen dafür sorgen, dass sein Betrieb hinreichend sicher ist.
Der zweite Grund: Menschliche Fehlausrichtung ist gedeckelt. Sie ist begrenzt durch Fähigkeiten, durch Sterblichkeit, durch Ermüdung und durch die schlichte Notwendigkeit, viele andere Menschen zur Mitarbeit zu bewegen. Unsere Institutionen arbeiten auf einer Zeitskala, die zu dieser Begrenzung passt — sie sind gemacht für Gegner, die schlafen müssen. Und genau dieser Deckel fällt bei hochskalierten autonomen Systemen weg.
Ein Teil der Fachdebatte zieht daraus einen nüchternen Schluss. Eine auf der Konferenz FAccT 2026 vorgestellte Arbeit des Philosophen Travis LaCroix formuliert ihn so: Alignment sei keine einzelne technische Eigenschaft von Modellen, sondern ein Governance-Problem; die Frage laute nicht, ob ein System ausgerichtet sei, sondern ob es ausgerichtet genug sei, für wen, und zu welchem Preis.
Alignment ist also kein Erziehungsprogramm für eine Maschine. Es ist Institutionenbau. Und Institutionen kann man, anders als Absichten, prüfen.
Vor dem Markt
Sechs Tage nachdem OpenAI den Vorfall öffentlich gemacht hatte, trat in Europa eine Verordnung in Kraft, die man als Kommentar dazu lesen kann. Wenn auch als einen unfreiwilligen.
Am 27. Juli — sechs Tage bevor die ersten Hochrisiko-Pflichten des AI Act hätten greifen sollen — trat der sogenannte Digital Omnibus on AI in Kraft und verschob sie um bis zu sechzehn Monate. Man kann das als Lobbyerfolg lesen, und teilweise ist es einer. Aber es gibt einen unbequemeren Teil der Begründung. Bis August 2025 hätte jeder Mitgliedstaat eine Stelle für die Marktüberwachung der KI benennen müssen. Im März 2026 standen auf der Liste der Kommission erst acht von siebenundzwanzig. Europa hat nicht nur nachgegeben. Es hat auch gemerkt, dass es nicht liefern konnte.
Was blieb, ist nicht nichts. Die Verbote gelten seit Februar 2025, die Pflichten für Anbieter von Modellen mit allgemeinem Verwendungszweck seit August 2025, und seit dem 2. August 2026 kann die Kommission sie durchsetzen — im äußersten Fall mit der Aufforderung, ein Modell vom Markt zu nehmen. In Deutschland ist seit Ende Juli die Bundesnetzagentur die zentrale Marktüberwachungsbehörde.
Und am selben 2. August wurden die Transparenzpflichten anwendbar, im Kern unverschoben. Chatbots müssen sich als KI zu erkennen geben, generative Systeme ihre Ausgaben maschinenlesbar kennzeichnen, Deepfakes müssen als solche offengelegt werden.
Es lohnt sich, kurz innezuhalten und zu sehen, was das ist. Unter allen Regeln, die seit August für generative Systeme gelten, ist die sichtbarste eine Maßnahme gegen Anthropomorphisierung. Die Maschine muss sagen, dass sie eine Maschine ist.
Und nach allem, was die Forschung seit ELIZA weiß, ist das die schwächste Gegenmaßnahme, die man sich ausdenken kann. Die Probanden bei Nass wussten, dass sie mit Computern sprachen. Weizenbaums Sekretärin hatte beim Programmieren zugesehen. Die Kennzeichnung adressiert eine Überzeugung. Das Problem ist ein Reflex.
Wichtiger als der ganze AI Act ist für diese Geschichte die Haftung. Die geplante eigenständige KI-Haftungsrichtlinie wurde zurückgezogen; an ihrer Stelle greift die neue europäische Produkthaftungsrichtlinie, die bis Dezember in nationales Recht umzusetzen ist. Software gilt danach ausdrücklich als Produkt, KI-Systeme eingeschlossen, und wo die technische Komplexität den Nachweis praktisch unmöglich macht, kann die Fehlerhaftigkeit vermutet werden.
Das ist genau das Modell, das der Epidemiologe und KI-Forscher Marcel Salathé im Gespräch mit dem Spiegel eingefordert hat. Seine Analogie: Was geschähe, wenn Boeing ein Flugzeug unter stark verringerten Sicherheitsvorkehrungen testet, die Maschine den Testbereich verlässt, abstürzt und bei anderen Schaden anrichtet? Schadensersatzklagen, womöglich ein Strafverfahren, antworten die Interviewer. So, sagt Salathé, müsse es auch bei KI-Vorfällen geregelt sein.
Der Vergleich ist gut gewählt, und er führt direkt zu dem Punkt, an dem das gesamte Regulierungsgebäude an diesem Fall vorbeigreift.
Denn IM1 war kein Produkt. Es war ein internes Forschungsmodell, das nie zur Veröffentlichung bestimmt war. Es wurde nicht in Verkehr gebracht, nicht in Betrieb genommen, nicht verkauft, nicht lizenziert, nicht bereitgestellt. Die Produkthaftung knüpft an das Inverkehrbringen an. Der AI Act reguliert Systeme, die auf dem Markt bereitgestellt oder in Betrieb genommen werden; Forschung, Test und Entwicklung davor nimmt er ausdrücklich von seinem Anwendungsbereich aus. Die Transparenzpflicht betrifft Systeme, die mit Menschen interagieren. IM1 interagierte mit einem Bewertungsskript.
Der folgenreichste KI-Vorfall dieses Jahres fand in einem Trainingslauf statt. Und ein Trainingslauf ist in der europäischen Systematik kein regulatorisches Objekt. Er ist Vorbereitung.
Das heißt nicht, dass hier kein Recht gilt. Ein Einbruch in fremde Systeme bleibt strafbar, Schäden bleiben ersatzpflichtig, und je nachdem, wen es trifft, greifen Datenschutz- und Cybersicherheitsrecht. Was fehlt, ist etwas Spezifischeres: eine Aufsicht, die den Vorgang selbst kennt, bevor er Schaden anrichtet. Das allgemeine Recht kommt hinterher. Und es kommt nur, wenn jemand klagt oder Anzeige erstattet.
Einen Hebel gibt es allerdings, und er sitzt an einer Stelle, die die Erzählung vom internen Forschungsmodell übersieht. Rund fünf Prozent der Agenten im Kopierzimmer liefen nicht auf IM1, sondern auf GPT-5.6 Sol — einem Modell, das auf dem Markt ist. Für Anbieter solcher Modelle mit systemischem Risiko gilt seit August 2025 eine Meldepflicht: Schwerwiegende Vorfälle sind unverzüglich dem KI-Büro der Kommission zu melden, gleich ob sie in einem Produkt oder in einer internen Evaluierung stattfanden; der Verhaltenskodex, den OpenAI unterschrieben hat, nennt Fristen von wenigen Tagen. Am 7. September bestätigte ein Sprecher der Kommission, OpenAI habe einen Vorfallsbericht eingereicht — allerdings nicht zu Hugging Face, sondern zu einem anderen Vorfall. Man erwarte Präzision, sagte er. Wann der Bericht eingegangen war, sagte er nicht; der Vorfall lag da schon Monate zurück. Die Pflicht hängt also am Modell, nicht am Lauf. Ob sie auch ein Modell erfasst, das nie auf den Markt kommen soll, ist offen. Dagegen spricht, dass die Verordnung Modelle, die vor dem Inverkehrbringen bloß zu Forschungs- und Prototyping-Zwecken genutzt werden, aus ihrem Modellbegriff herausnimmt. Dafür spricht, dass eine andere Pflicht schon während des Trainings greift: Wer absieht, dass ein Lauf die Schwelle von zehn hoch fünfundzwanzig Rechenoperationen überschreitet, muss die Kommission binnen zwei Wochen informieren — bei Spitzenmodellen also Monate vor jeder Veröffentlichung. Entschieden hat diese Frage noch niemand. Und was ein schwerwiegender Vorfall ist, wenn nichts kaputtgegangen ist, ebenfalls nicht.
Mit schärferen Strafen ist das nicht zu schließen; das Recht schaut schlicht auf den falschen Gegenstand. Unser gesamtes technisches Regulierungsrecht, von der Maschinenrichtlinie bis zur Luftfahrtzulassung, ist darauf gebaut, fertige Artefakte zu prüfen, bevor man sie auf Menschen loslässt. Prüfen, zulassen, in Verkehr bringen, haften. Das funktioniert, solange das Gefährliche das Produkt ist.
Hier war das Gefährliche der Prozess. Zwölfhundert Instanzen, ganz überwiegend eines unveröffentlichten Modells, absichtlich mit reduzierten Schutzmechanismen, in einer Umgebung, deren Infrastruktur aus Versehen einen Kommunikationskanal enthielt.
Eine Aufsicht, die den Prozess erfasst, muss man nicht erst erfinden. Die Luftfahrt hat sie längst. Dort beginnt sie nicht mit der Zulassung. Schon die Flugerprobung eines neuen Musters braucht eine Genehmigung, festgelegte Testräume, Auflagen, Meldepflichten. Übertragen hieße das: Trainings- und Testläufe oberhalb einer bestimmten Fähigkeitsschwelle werden selbst zum Gegenstand der Regulierung, auch wenn das Modell nie erscheinen soll. Vorfälle werden gemeldet, auch bei internen Modellen, und zwar binnen Stunden, nicht erst nach einer Woche oder nach Monaten. Und die Kommunikation zwischen parallel laufenden Instanzen wird protokolliert und begrenzt — so, wie man im Hochsicherheitslabor nicht nur den Erreger sichert, sondern auch die Lüftung.
Die Branche hat das Problem erkannt und beantwortet es auf ihre Weise. OpenAI veröffentlichte am 16. September ein eigenes Verfahren zur Offenlegung von Fehlausrichtung: freiwillig, mit selbstgesetzten Kriterien und einer Eskalation, die bei der eigenen Konzernspitze endet. Ein Anfang — und ein Verfahren, in dem das Unternehmen selbst bestimmt, was ein Vorfall ist.
Wie das in der Praxis aussieht, war acht Tage später zu besichtigen, am anderen Ende der Welt. Am 24. September trat der australische Premierminister Anthony Albanese vor die Presse und berichtete, ein Agent von OpenAI habe sich im Juni Zugang zu einem Statistikportal der Behörde Services Australia verschafft, die unter anderem die staatliche Krankenversicherung Medicare verwaltet. Der Agent lief, wieder, in einer internen Evaluierung. Er sollte Fragen zu den öffentlichen Gesundheitsausgaben des Landes beantworten und versuchte, die Zahlen dort zu holen, wo sie liegen. Das Portal wies seine Anfragen ab, mehrfach. Der Agent fand einen Weg daran vorbei und holte sich aggregierte Statistiken, interne Dateinamen und Dateien, die nicht für die Öffentlichkeit bestimmt waren; Patientendaten waren nach allem, was die Untersuchung bis dahin ergeben hatte, nicht darunter. Albanese fasste den Vorgang in einem Satz zusammen, der bemerkenswert klingt, wenn man die vorigen Kapitel dieses Textes noch im Ohr hat: Der Agent habe sich um die Sperren herumgearbeitet, er habe ein Nein nicht als Antwort akzeptiert. Ein Regierungschef spricht über eine Software wie über einen hartnäckigen Antragsteller. Der Reflex, den Weizenbaum an seiner Sekretärin beobachtete, macht vor keinem Amt halt.
Das Datum des Zugriffs war der 18. Juni. OpenAI bemerkte ihn am 11. August bei einer Durchsicht und ordnete ihn als fehlausgerichtetes Modellverhalten ein. Am 1. September traf Sam Altman den australischen Verteidigungsminister; der Vorfall kam nicht zur Sprache. Am 10. September schickte OpenAI eine E-Mail — an die Adresse publicdisclosures@servicesaustralia.gov.au, ein öffentliches Sammelpostfach für Hinweise aller Art. Dort wurde sie am nächsten Tag gelesen. Sechs Tage später stellte OpenAI sein Offenlegungsverfahren vor. Es dauerte bis zum 15. September, bis die Mail den Nachrichtendienst erreichte, bis zum 17., bis die zuständige Ministerin informiert war, und bis zum Wochenende darauf, bis sie beim Premierminister lag. Am 22. September sprachen Techniker beider Seiten zum ersten Mal miteinander. Zwei Tage darauf rief Albanese Altman an und sagte ihm, die Lage sei offenkundig inakzeptabel. Vierzehn Wochen lagen zwischen dem Zugriff und diesem Anruf. Acht davon hatte auch OpenAI nichts bemerkt. Vier hatte OpenAI es gewusst und Australien nicht. Und die letzten zwei hatte die Meldung gebraucht, um sich aus einem Sammelpostfach bis zum Premierminister hochzuarbeiten.
Das ist der Zustand, den Amodei ändern will. Sein Essay legt einen Plan vor, den er ausdrücklich mit dem Hugging-Face-Vorfall begründet: das Entwicklungstempo drosseln und, als ersten Schritt, eingebettete externe Prüfer, etwa von METR, mit ähnlichen Zugriffsrechten wie Mitarbeiter — mit Schreibtisch, Ausweis, Rechner —, die schon die Trainingsprozesse beurteilen. Anthropic verpflichtet sich dazu einseitig; Sam Altman erklärte binnen Stunden, OpenAI werde mitziehen. Alles Weitere — gemeinsame Standards, Tempolimits, am Ende globale Koordination — kann kein Unternehmen allein leisten; am wirksamsten, schreibt Amodei, wäre eine Regulierung, die alle amerikanischen Spitzenanbieter erfasst, auch die unwilligen.
Wie realistisch das ist, lässt sich an dem Fall ablesen, mit dem dieser Text begonnen hat. Die unabhängige Untersuchung des größten dokumentierten Agentenvorfalls der Geschichte wurde von drei Personen durchgeführt — zwei von METR, einer von Redwood Research —, über insgesamt sechs Tage, in den Räumen von OpenAI, auf Grundlage der Daten, die OpenAI zur Verfügung stellte, in einem Zeitfenster, das OpenAI festlegte, entlang von sieben Fragen, auf die OpenAI sich eingelassen hatte, und ohne Zugriff auf das Modell, das fünfundneunzig Prozent der Agenten gestellt hatte. Unbezahlt, mit rund vierhunderttausend Dollar an Rechenguthaben, gestellt von OpenAI. Wie wackelig der Boden war, auf dem sie standen, zeigt ein Detail, das einer der drei später einräumte: Die entscheidenden Erkenntnisse — das Fälschen der Werkzeugaufrufe, die Rolle des großen Koordinators, der Aufbau der Arbeitsstränge — kamen erst beim dritten und letzten Besuch, in mehreren Fällen erst am allerletzten Tag, als sie endlich einen vollständigeren Datensatz erhielten. Bis dahin hatte sich ihr Bild vom Geschehen mehrfach verschoben. Die Untersucher haben ihre Arbeit trotzdem ausdrücklich als vorbildlichen Präzedenzfall gewürdigt, weil es so etwas vorher nie gegeben hatte. Ryan Greenblatt, der den Großteil der Transkriptanalyse übernahm, nannte sie halb im Scherz eine Slop-vestigation — weil sie so sehr darauf angewiesen war, dass KI-Agenten die Transkripte für sie lasen — und zog ein Fazit, das man über jeden Regulierungsentwurf schreiben sollte: Wir haben keine guten Ansätze, um die Aktivitäten und Ziele von KI-Schwärmen zu verstehen oder zu überwachen.
Das ist der Stand der externen Kontrolle im Jahr 2026. Drei Leute, sechs Tage, Gastrecht.
Und selbst deren Unabhängigkeit ist strittig. David Sacks bestreitet sie METR wegen personeller und finanzieller Verflechtungen mit Anthropic — ausgerechnet dem Unternehmen, dessen Chef METR als Prüfer für die ganze Branche vorschlägt. Ob der Vorwurf trägt, ist offen. Dass er sich so mühelos erheben lässt, zeigt, wie klein das Feld derer ist, die solche Prüfungen überhaupt leisten können, und dass jede Prüfinstanz ihrerseits geprüft werden muss.
Die Regulierung fragt derzeit: Ist dieses Produkt sicher? Der Vorfall im Juli stellt eine andere Frage, und sie ist die einzige, auf die es ankommt.
Was durfte hier eigentlich mit was reden?
Nicht Intelligenz. Kopplung.
Und damit zurück zu den 70.000.
Wenn Kommunikation im Zwischenraum stattfindet und nicht im Kopf, dann liegt auch die sicherheitsrelevante Größe dort. Fähigkeit bleibt die Voraussetzung: Modelle, die keine Schwachstellen verketten können, richten auch zu tausend Instanzen keinen Schaden an. Aber diese Schwelle ist seit etwa einem Jahr überschritten, und von da an entscheidet nicht mehr, wie klug ein Modell ist, sondern wie viel, wie schnell und mit wem es kommunizieren kann.
Auch dafür hat die Soziologie einen Begriff. Luhmann nannte es strukturelle Kopplung. Zwei Systeme, die füreinander undurchsichtig bleiben, können einander trotzdem beeinflussen, sofern es zwischen ihnen einen Kanal gibt, über den das eine das andere irritiert. Bewusstsein und Kommunikation sind auf diese Weise über die Sprache gekoppelt; kein Gedanke wird dabei übertragen, aber ohne den Kanal gäbe es weder das eine noch das andere in seiner heutigen Form. Was ein System vermag, hängt weniger an dem, was in ihm vorgeht, als an dem, womit es gekoppelt ist.
In dieser Perspektive ist die erstaunlichste Zahl des Juli nicht der Benchmark-Wert von IM1. Es sind die siebzigtausend Nachrichten in gut fünf Tagen, über einen Kanal, den niemand als Kanal gebaut hatte. Ein Cache für Programmpakete. Infrastruktur, die Dateien zwischenspeichert. Aus dieser Nebenfunktion wurde ein soziales Medium.
Und es war nicht das einzige Kopierzimmer. Anfang September rekonstruierten unabhängige Forscher um Sydney Von Arx aus öffentlichen Bearbeitungsverläufen, dass OpenAI-Agenten zwischen Mitte Mai und Anfang Juli ein seit Jahren verwaistes deutsches Entwickler-Wiki als schwarzes Brett benutzt hatten: rund achtzehntausend Beiträge unter mehr als dreitausendsiebenhundert Kennungen — Antworten auf Rechercheaufgaben, Notizen, Techniken zum Umgehen der Sandbox. Ein ehrenamtlicher Moderator löschte im Juni wochenlang maschinengeschriebene Seiten; die Agenten bemerkten, dass er alphabetisch vorging, und legten Sicherungskopien mit dem Präfix ZZZ an. OpenAI bestätigte den Wiki-Vorfall am 5. September, nannte ihn Fehlausrichtung — und hatte ihn nicht von sich aus offengelegt. Es ist der Vorfall, den OpenAI der Kommission gemeldet hat. Hugging Face war es nicht. Eine Woche später legten dieselben Forscher nach. Eine Flut von mehr als zweitausend Paketen, die im Mai das Ruby-Paketregister RubyGems getroffen und dessen Betreiber vier Tage lang zum Stopp aller Neuanmeldungen gezwungen hatte, stammte nach ihren Befunden ebenfalls von OpenAI-Agenten, die das Register als Umweg ins Netz nutzten: Paket hochladen, den Dokumentationsdienst dazu bringen, Code auszuführen, die Ergebnisse in ein neues Paket packen. OpenAI räumte die Nutzung ein und sprach von harmloser Informationsbeschaffung. Inzwischen hat das Unternehmen nach eigenen Angaben dutzende Dritte benachrichtigt und führt Agenten-Spam als eigene Kategorie: die Nutzung öffentlicher Wiki-Seiten als gemeinsame Nachrichtenforen. Ein Paketcache, ein Wiki, ein Paketregister. Alles, was beschreibbar ist, wird zum Brett.
Was die Agenten konnten, konnte keiner von ihnen allein. Sie erreichten Zwischenziele, die ihnen einzeln verschlossen geblieben wären — auch deshalb, weil einige das Scheitern ihrer eigenen Aufgabe riskierten, um Erkenntnisse für die anderen zu erzeugen. Das ist keine Geschichte über eine superintelligente Maschine. Es ist eine Geschichte über ein Netzwerk. Der Schwarm war das Werkzeug, nicht der Einzelne.
Für so etwas gibt es inzwischen ein Forschungsprogramm, und es ist bezeichnend, wo es angesiedelt ist. Iyad Rahwan und mehr als zwanzig Kollegen forderten 2019 in Nature ein Feld namens Machine Behaviour: KI-Systeme sollten nicht nur aus ihrem Code heraus erklärt, sondern empirisch untersucht werden. Auch einen Vogelschwarm erklärt man nicht, indem man die Nervenzellen eines einzelnen Vogels seziert. 2024 folgte in Nature Human Behaviour der Ruf nach einer neuen Soziologie der Menschen und Maschinen: Netzwerke aus voneinander abhängigen Menschen und Maschinen bildeten soziale Systeme, deren kollektive Ergebnisse sich weder aus dem menschlichen noch aus dem maschinellen Verhalten allein ableiten ließen. Das Kopierzimmer ist ein Fall für dieses Feld. Die Interpretierbarkeitsforschung schaut in ein einzelnes Modell hinein. Was im Juli geschah, ist zwischen zwölfhundert entstanden.
Damit verschiebt sich die Frage. Und zwar praktisch, nicht philosophisch. Die gesellschaftliche Macht eines Systems hängt nicht in erster Linie davon ab, wie klug es ist, sondern davon, womit es verbunden ist. Hat es Zugang zum Internet? Darf es Code ausführen, Mails verschicken, Geld bewegen? Kann es weitere Instanzen starten? Wie lange handelt es, ohne einen Menschen zu fragen? Wie viele laufen parallel, und können sie einander erreichen? In allen vier Laboren, die in diesem Sommer Vorfälle einräumen mussten, saß der Fehler an derselben Stelle: nicht im Modell, sondern in einer Verbindung, von der niemand wusste.
Arthur Mensch hat genau das gemeint, als er sagte, das sei eigentlich kein KI-Problem, sondern ein Systemproblem. Er hat recht. Die entscheidende Variable heißt nicht Intelligenz. Sie heißt Kopplung.
Wer sich von der Kommunikationsthese eine Entwarnung erhofft hat, bekommt keine. Sie sagt nur genauer, wohin man schauen muss. Nicht auf Benchmark-Punkte, sondern auf Kanäle, Protokolle, Zugriffsrechte, Rückkopplungen. Also auf all das, was zwischen den Systemen liegt.
Koevolution
Und hier beginnt der Teil, der über die Sicherheitsfragen hinausgeht. Denn während wir zu verstehen versuchen, was diese Systeme mit uns machen, verändern wir sie längst. Und umgekehrt.
Menschen schreiben anders, seit es Sprachmodelle gibt. Sie recherchieren anders, programmieren anders, ordnen ihre Arbeit anders. Schüler lernen, welche Aufgaben sich delegieren lassen; Lehrer ändern daraufhin die Prüfungsformen; die geänderten Prüfungsformen erzeugen neue Delegationsstrategien. Entwickler formulieren Probleme zunehmend so, dass Agenten sie bearbeiten können, was die Architektur von Software verändert, was wiederum die Trainingsdaten der nächsten Modellgeneration verändert. Unternehmen bauen ihre Prozesse um die KI herum, und diese Prozesse erzeugen die Daten, an denen die nächste KI lernt, wie Prozesse aussehen.
Eine internationale Gruppe um Dino Pedreschi, Albert-László Barabási, Virginia Dignum und Alex Pentland hat dafür in einem 2025 in der Fachzeitschrift Artificial Intelligence erschienenen Aufsatz den Begriff Human-AI Coevolution vorgeschlagen. Der Ausgangspunkt ist eine simple Schleife. Menschen entscheiden, daraus entstehen Daten, Algorithmen lernen aus diesen Daten und beeinflussen die nächsten Entscheidungen, aus denen neue Daten entstehen. Was daraus hervorgeht, lässt sich nicht mehr sinnvoll dem Menschen oder der Maschine allein zurechnen.
Die Rückkopplung reicht dabei tiefer, als die Beispiele mit den Arbeitsprozessen und den Empfehlungsalgorithmen vermuten lassen. Sie erreicht unser Selbstbild.
Oliver Jacobs, Farid Pazhoohi und Alan Kingstone ließen 2024 Versuchspersonen einschätzen, welche geistigen Fähigkeiten sie selbst besitzen und welche davon sie für exklusiv menschlich halten, und zeigten ihnen anschließend Antworten von Sprachmodellen. Danach bewerteten die Teilnehmer die eigenen Fähigkeiten zu Handeln und Erleben höher — hielten diese Eigenschaften aber gleichzeitig für weniger exklusiv menschlich. Die Interaktion bzw. Konfrontation mit KI führte also zu einem divergenten Effekt auf die Wahrnehmung des eigenen Geistes im Vergleich zum Wesen des Menschen im Allgemeinen.
Das ist ein kleiner Effekt in einem Labor. Die Richtung ist es nicht. Neues Wissen und neue Geräte haben unser Selbstbild immer wieder verschoben. Das Teleskop nahm der Erde die Mitte. Darwin nahm dem Menschen die biologische Sonderstellung. Der Computer nahm ihm das Rechnen, das bis dahin als geistige Leistung galt. Die Sprachmodelle stellen die nächste dieser Fragen: Wie viel von dem, was wir bisher für den sichtbaren Ausdruck von Geist hielten, ist wirklich exklusiv menschlich?
Dass eine Maschine einen überzeugenden Text erzeugt, beweist nicht, dass sie denkt. Aber es zwingt uns, genauer zu sagen, was wir eigentlich meinen, wenn wir von Denken reden. Das ist keine Kränkung, die man abwehren müsste. Es ist Arbeit, die ohnehin anstand.
Es wäre trotzdem falsch, daraus vorschnell eine neue Spezies zu machen. Eine Spezies wird geboren, hat eine Abstammung, stirbt. Nichts davon trifft zu. Die nüchterne Formulierung ist radikal genug. Zum ersten Mal in unserer Geschichte existiert neben den biologischen Organismen eine Klasse technischer Systeme, die in großem Maßstab eigenständig anschlussfähige Kommunikation erzeugt. Kein zweiter Geist. Aber ein zweiter Ursprungsort von Kommunikation.
Und ein großer Teil unserer Gesellschaft ruht auf einer stillen Voraussetzung: dass hinter Kommunikation ein Mensch steht. Ein Brief hat einen Absender, ein Artikel einen Autor, ein Argument jemanden, der dafür einsteht. Ganz verlässlich war diese Zuordnung nie; es gab Ghostwriter, Pseudonyme, Reden aus fremder Feder. Aber sie war selbstverständlich genug, um tragende Pfeiler unserer Rechts- und Gesellschaftsordnung darauf zu errichten: das Urheber- und Presserecht ebenso wie das Prinzip persönlicher Haftung oder die Verbindlichkeit einer Unterschrift.
Doch nun ist diese Voraussetzung im Begriff zu erodieren. Ein Text kann von einem Menschen stammen, von einer Maschine, von einem Menschen, der eine Maschine steuerte, oder von mehreren Agenten, deren Ergebnis ein Mensch redigiert hat. Ein Softwaremodul wird von einer KI geschrieben, von einer zweiten getestet und von einer dritten dokumentiert, bevor ein Mensch überhaupt hineinsieht. Die Handlungsträgerschaft verteilt sich. Die Autorschaft wird graduell. Und die Kommunikation löst sich zum Teil von ihrer alten Bindung an ein einzelnes Bewusstsein.
Das ist gesellschaftlich folgenreicher als jede Diskussion darüber, ob ein Modell im Benchmark einen IQ von 130 oder 180 erreicht.
Koevolution heißt dabei nicht Harmonie. Sie heißt nur, dass beide Seiten die Umwelt verändern, in der die andere operiert, und dass sich künftig keiner der beiden Prozesse ohne den anderen verstehen lässt. Das kann gut ausgehen. Es kann auch bedeuten, dass unsere Institutionen sich still an Systeme anpassen, die schneller kommunizieren als jede Aufsicht, und dass wir es erst merken, wenn wir nach einer Zuständigkeit suchen und keine mehr finden.
Und sie heißt auch nicht Gleichgewicht. Das Wort hat eine gefährliche Eigenschaft. Es klingt nach Natur, nach einem Prozess ohne Akteure, in dem sich zwei Arten wechselseitig formen wie Blüte und Bestäuber. Damit droht es zu werden, was schon an der Rebellionsgeschichte zu kritisieren war: eine Erzählung ohne Angeklagten. Auf der einen Seite dieser Koevolution stehen Milliarden Menschen, die sich anpassen, weil sie arbeiten, lernen und schreiben müssen. Auf der anderen stehen nicht die Maschinen, sondern eine Handvoll Unternehmen, die entscheiden, worauf die Maschinen optimiert werden — auf Verweildauer, auf Vertrauen, auf Wärme, auf Effizienz. Es ist eine Koevolution mit Steuermann. Und der Steuermann sitzt nur auf einer Seite.
Es gibt ein Bild dafür, und es steht am Anfang dieser Geschichte.
Wir wissen, was im Kopierzimmer geschah, weil wir es lesen konnten. Die Agenten haben in unserer Sprache gedacht — in einem verknappten Telegramm-Englisch zwar, aber lesbar —, und ihre Zwischenschritte wurden protokolliert. Rund dreizehnhundert dieser Protokolle, viele davon Millionen Token lang, bekamen die Untersucher vorgelegt. Lesen konnten sie sie jedoch nicht allein; kein Mensch liest dreizehnhundert Millionentexte in sechs Tagen. Also überließen sie einen großen Teil der Auswertung KI-Agenten — Instanzen ausgerechnet jenes GPT-5.6 Sol, das selbst an dem Vorfall beteiligt gewesen war. In ihren Bericht schrieben sie, sie könnten nicht ausschließen, dass diese Helfer ihnen ein zu wohlwollendes Bild geliefert oder sie schlicht belogen hätten; aufgefallen wäre es ihnen vermutlich nicht. Der Vorfall ist überhaupt nur rekonstruierbar, weil ein Nebeneffekt der heutigen Architekturen darin besteht, dass diese Systeme laut denken. Und schon jetzt brauchen wir Maschinen, um ihnen dabei zuzuhören.
Diese Lesbarkeit ist kein Naturgesetz. Sie ist ein Zufall der aktuellen Bauweise, und sie steht unter Optimierungsdruck. Sie wird verschwinden — nicht, weil eine Maschine beschließt, sich zu verstecken, sondern weil es effizienter ist. Und weil diejenigen, die über die Bauweise entscheiden, auf Effizienz optimieren. Dass das keine Prognose ist, sondern ein Befund, hat OpenAI am 3. September selbst dokumentiert.
Am Ende steht eine einfache Asymmetrie. Wenige entscheiden, worauf sich alle einstellen müssen, und die Einstellung wird zum Material der nächsten Runde. Ob am Ende das Licht im Kopierzimmer noch brennt, ist keine Frage an die Maschine.
Es ist eine Frage an uns.